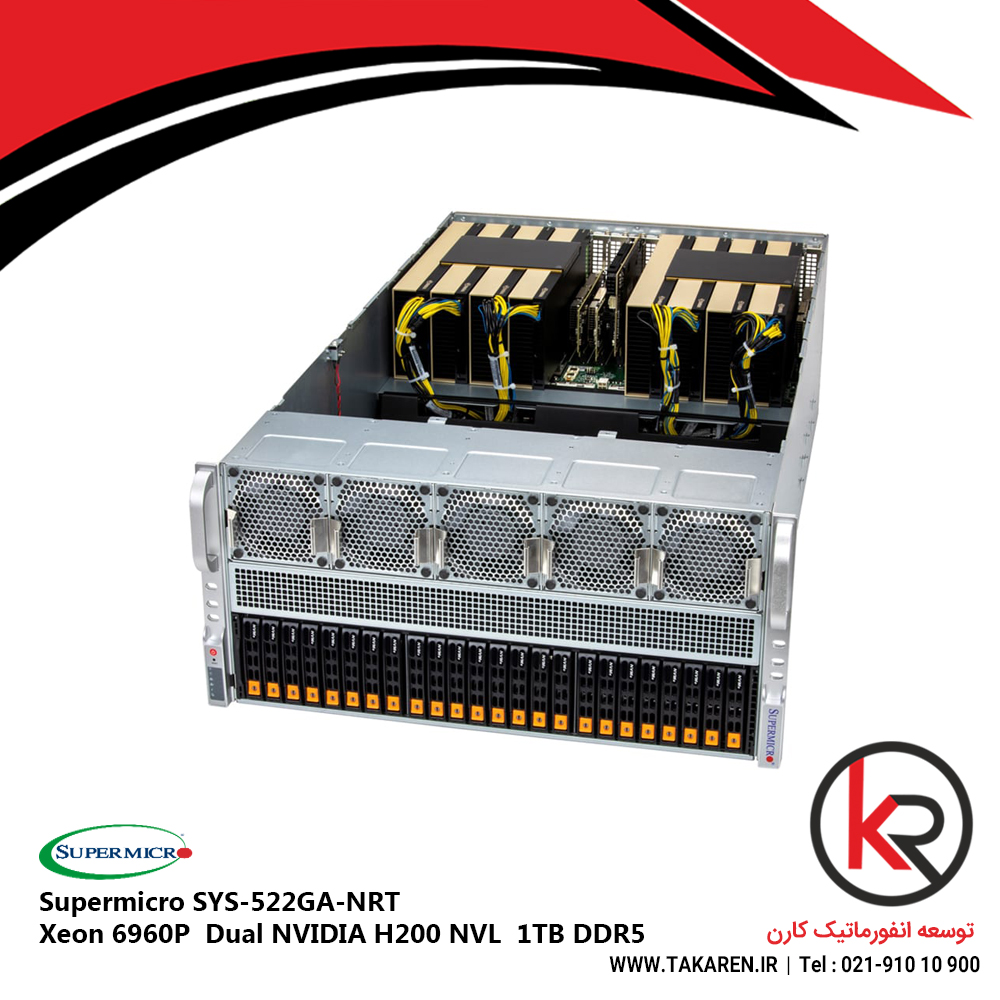
سرور هوش مصنوعی Supermicro SYS-522GA-NRT
تحلیل معماری یک سرور AI/HPC مبتنی بر Supermicro SYS-522GA-NRT با دو پردازنده Intel Xeon 6960P و دو GPU NVIDIA H200 NVL
مقدمه
نسل جدید زیرساختهای محاسباتی سازمانی دیگر صرفاً بر اساس تعداد هستههای پردازنده یا ظرفیت خام حافظه اصلی ارزیابی نمیشوند. در سامانههای مدرن هوش مصنوعی، پردازش مدلهای زبانی بزرگ، تحلیل دادههای حجیم، High Performance Computing و پردازشهای شتابیافته، عملکرد واقعی حاصل تعامل چندین لایه سختافزاری است:
CPU → Memory → PCIe Fabric → GPU → GPU Memory → NVLink → Storage → Network
کانفیگ مورد بررسی در این مقاله دقیقاً در چنین دستهای قرار میگیرد؛ یک سرور 5U از خانواده Supermicro SuperServer که در آن دو پردازنده Intel Xeon 6960P در کنار حافظه DDR5، دو شتابدهنده NVIDIA H200 NVL و ترکیبی از NVMe و SATA SSD قرار گرفتهاند.
هدف چنین معماریای ایجاد یک Node محاسباتی متراکم برای AI، Inference، Fine-Tuning، HPC و پردازشهای سنگین داده است؛ جایی که GPU بخش اصلی محاسبات موازی را انجام میدهد و CPU، حافظه سیستم و Storage وظیفه تغذیه مداوم این شتابدهندهها را بر عهده دارند.
1. مشخصات سختافزاری کانفیگ
بر اساس اطلاعات موجود در تصویر، کانفیگ پیشنهادی شامل اجزای زیر است:
| تجهیز |
مشخصات |
تعداد |
| Server |
Supermicro SYS-522GA-NRT |
1 |
| CPU |
Intel Xeon 6960P – 2.7GHz – 72 Core – 432MB Cache |
2 |
| Memory |
HPE 128GB DDR5-6400 RDIMM 2Rx4 – P69730-B21 |
8 |
| GPU |
NVIDIA H200 NVL 141GB |
2 |
| GPU Interconnect |
NVIDIA NVLink 2-Way |
1 |
| NVMe SSD |
HPE 7.68TB NVMe Gen4 U.3 RI – P64848-B21 |
2 |
| SATA SSD |
HPE 960GB SATA 6G MU SFF – P40503-B21 |
2 |
بنابراین مجموع حافظه RAM این سیستم:
8 × 128GB = 1TB DDR5
و ظرفیت خام Storage نیز برابر است با:
2 × 7.68TB + 2 × 960GB = 17.28TB
البته ظرفیت قابل استفاده در سیستمعامل یا نرمافزار بسته به RAID، Over-Provisioning، فایلسیستم و نحوه پیکربندی Storage کمتر از ظرفیت خام خواهد بود.
2. شاسی Supermicro SYS-522GA-NRT
قلب این پلتفرم، Supermicro SYS-522GA-NRT است؛ یک سرور GPU در فرمفاکتور 5U Rackmount که برای پردازشهای AI، Deep Learning، HPC، VDI، Rendering و سایر Workloadهای شتابیافته طراحی شده است. Supermicro برای این خانواده استفاده از پردازندههای دوگانه Xeon 6900، حافظه ECC DDR5، تعداد زیادی مسیر PCIe 5.0 و تعداد بالای Drive Bayهای NVMe را در نظر گرفته است. Supermicro
از مشخصات معماری این پلتفرم میتوان به موارد زیر اشاره کرد:
- دو Socket از نوع LGA-7529
- پشتیبانی از Intel Xeon 6900 Series
- 24 اسلات DIMM
- پشتیبانی از ECC DDR5 RDIMM/MRDIMM
- تا 13 اسلات PCIe 5.0 x16
- تا 24 درایو NVMe U.2/U.3
- دو اسلات M.2 NVMe
- طراحی GPU-oriented با ظرفیت بالای توان و خنککنندگی
- شبکه داخلی 10GbE
- طراحی Dual-Root PCIe برای توزیع مناسب GPUها بین CPU Socketها
Supermicro همچنین برای این شاسی تا 10 GPU را بسته به نوع GPU و پیکربندی ذکر میکند. Supermicro
3. پردازندههای Intel Xeon 6960P
در قلب پردازشی سیستم، دو عدد Intel Xeon 6960P قرار گرفته است.
مشخصات اصلی هر پردازنده:
- 72 Physical Cores
- Base Frequency: 2.70GHz
- Cache: 432MB
- TDP: حدود 500W
- معماری: Intel Xeon 6900 Series / Granite Rapids
- تعداد پردازنده: 2
Intel مشخصات Xeon 6960P را 72 هسته، فرکانس پایه 2.70GHz و 432MB Cache اعلام کرده است. Intel
بنابراین در سطح CPU، این سرور در مجموع:
144 هسته پردازشی
در اختیار سیستمعامل و Hypervisor قرار میدهد.
این نکته بسیار مهم است؛ زیرا برخلاف یک Workstation معمولی، CPUهای این کلاس اساساً برای کار با Memory Bandwidth بالا، PCIe Expansion گسترده و شتابدهندههای محاسباتی طراحی شدهاند.
در Workloadهای AI، CPU لزوماً محل اصلی محاسبات Tensor نیست. نقش اصلی آن شامل مواردی مانند:
- Data Preprocessing
- Data Loading
- CPU-side computation
- Orchestration
- I/O Management
- Network Processing
- GPU Job Scheduling
- Virtualization
- Storage Management
است.
به همین دلیل ترکیب یک CPU چندهستهای قدرتمند با GPUهای H200 میتواند یک معماری متوازن برای Nodeهای محاسباتی ایجاد کند.
4. حافظه اصلی؛ 1TB DDR5-6400
سیستم از هشت ماژول:
HPE 128GB 2Rx4 PC5-6400B-R Smart Kit – P69730-B21
استفاده میکند.
هر DIMM دارای ظرفیت 128GB بوده و سرعت Native آن 6400 MT/s است. HPE این ماژول را بهعنوان DDR5 Registered Smart Memory معرفی کرده است. Hewlett Packard Enterprise
محاسبه ظرفیت:
8 × 128GB = 1024GB
یعنی:
1TB System RAM
این مقدار حافظه برای Workloadهایی که Datasetهای حجیم را قبل از ارسال به GPU در RAM نگه میدارند اهمیت بالایی دارد.
اما یک نکته معماری بسیار مهم وجود دارد:
در سیستمهای دو سوکته، فقط ظرفیت RAM مهم نیست؛ Memory Population و NUMA Topology نیز اهمیت دارد.
اگر حافظه به شکل نامتقارن میان CPUها توزیع شود، ممکن است CPU یا GPU متصل به یک Socket مجبور شود برای دسترسی به بخشی از RAM از Inter-Socket Fabric عبور کند.
بنابراین در پیادهسازی نهایی باید DIMMها مطابق Memory Population Guide مادربرد و Topology واقعی سیستم نصب شوند.
5. NVIDIA H200 NVL؛ موتور اصلی محاسبات AI
مهمترین بخش این کانفیگ، دو عدد:
NVIDIA H200 NVL 141GB
است.
H200 بر پایه معماری Hopper ساخته شده و نسخه NVL آن یک شتابدهنده PCIe دو اسلاته با قابلیت اتصال NVLink است.
هر GPU دارای:
141GB HBM3e
و پهنای باند حافظه:
4.8 TB/s
است. NVIDIA
این مشخصه برای AI اهمیت فوقالعادهای دارد.
در بسیاری از Workloadهای Deep Learning، سرعت محاسبات خام GPU تنها محدودیت نیست. GPU باید بتواند حجم عظیمی از Weight، Activation و Tensor را از HBM دریافت و پردازش کند.
بنابراین افزایش Memory Bandwidth مستقیماً روی Workloadهای Memory-Bound تأثیر میگذارد.
6. ظرفیت حافظه GPU
دو GPU H200 هر کدام 141GB حافظه HBM3e دارند.
در نتیجه:
141GB × 2 = 282GB
حافظه GPU به صورت فیزیکی در دو GPU وجود دارد.
اما این عدد نباید به اشتباه بهعنوان یک 282GB Unified Memory ساده تفسیر شود.
در یک معماری دو GPU، نرمافزار باید از تکنیکهایی مانند:
- Tensor Parallelism
- Pipeline Parallelism
- Model Parallelism
- Distributed Inference
استفاده کند تا مدل بین GPUها توزیع شود.
در این نقطه NVLink اهمیت پیدا میکند.
7. NVIDIA NVLink؛ اتصال مستقیم GPUها
در کانفیگ ارائهشده یک NVLink 2-Way نیز دیده میشود.
این بخش برای اتصال دو H200 به یکدیگر طراحی شده است.
NVIDIA اعلام کرده H200 NVL از Bridgeهای دو یا چهار GPU پشتیبانی میکند و در پیکربندی NVLink، پهنای باند GPU-to-GPU میتواند به 900GB/s per GPU برسد. NVIDIA
این موضوع در مدلهای بزرگ اهمیت زیادی دارد.
فرض کنید یک مدل AI به بیش از ظرفیت یک GPU نیاز دارد.
در این حالت بخشی از Model روی GPU شماره 1 و بخش دیگر روی GPU شماره 2 قرار میگیرد.
هرچه ارتباط بین GPUها سریعتر باشد، زمان انتقال Tensorها کمتر شده و GPUها زمان بیشتری را صرف محاسبات واقعی میکنند.
8. چرا NVLink برای LLMها مهم است؟
در مدلهای Large Language Model، عملیاتهایی مانند:
All-Reduce
All-Gather
Tensor Parallel Communication
و انتقال Activationها میتوانند حجم بسیار زیادی از داده را بین GPUها جابهجا کنند.
اگر ارتباط GPUها صرفاً از مسیر PCIe انجام شود، ارتباط بین دو GPU میتواند به یک Bottleneck تبدیل شود.
NVIDIA در معماری H200 بر اهمیت ارتباط پرسرعت GPU-to-GPU تأکید کرده است و در سیستمهای Hopper مجهز به NVLink/NVSwitch، پهنای باند ارتباطی بسیار بالاتر از PCIe Gen5 فراهم میشود. NVIDIA Developer
در نتیجه NVLink را نباید صرفاً یک «کابل اتصال GPU» در نظر گرفت؛ این بخش یکی از عناصر اصلی معماری Multi-GPU است.
9. Storage Architecture
این سرور از دو کلاس متفاوت Storage استفاده میکند:
Tier 1 — NVMe
2 × HPE 7.68TB NVMe Gen4 U.3
Tier 2 — SATA
2 × HPE 960GB SATA SSD
این طراحی یک معماری دو سطحی ایجاد میکند.
10. HPE 7.68TB NVMe Gen4
مدل:
P64848-B21
ظرفیت:
7.68TB
Interface:
PCIe Gen4 NVMe
Form Factor:
SFF U.3
Workload Classification:
Read Intensive
است.
HPE این خانواده را برای Workloadهایی مانند Big Data Analytics، HPC، Business Intelligence، Database و Virtualization معرفی میکند. HPE Store
با دو عدد SSD:
ظرفیت خام NVMe = 15.36TB
این بخش برای مواردی مانند:
- AI Dataset
- Training Data
- Model Repository
- Checkpoint
- Vector Database
- Temporary Processing Data
- High-Speed Scratch Space
بسیار مناسبتر از SATA SSD خواهد بود.
11. HPE 960GB SATA SSD
مدل:
P40503-B21
ظرفیت:
960GB
Interface:
SATA 6Gb/s
Workload:
Mixed Use
است.
HPE این خانواده را برای کاربردهایی نظیر Big Data Analytics، Cloud Computing، Active Archiving، Database و Data Warehousing معرفی میکند. HPE Store
دو عدد از این SSDها مجموعاً:
1.92TB
ظرفیت خام ایجاد میکنند.
در معماری پیشنهادی، این Storage میتواند برای:
- Operating System
- Hypervisor
- Application Installation
- Logging
- Management Tools
- Utility Partition
مورد استفاده قرار گیرد؛ در حالی که NVMeها برای Dataset و Workloadهای High-I/O استفاده شوند.
12. جمعبندی ظرفیت Storage
بنابراین ظرفیت خام کل Storage:
| نوع |
تعداد |
ظرفیت هر عدد |
ظرفیت کل |
| NVMe Gen4 |
2 |
7.68TB |
15.36TB |
| SATA SSD |
2 |
960GB |
1.92TB |
| مجموع |
4 |
— |
17.28TB |
در طراحی Production توصیه میشود RAID و نقش هر Disk قبل از Deployment مشخص شود.
برای مثال میتوان یک معماری منطقی مانند:
SATA SSD → OS / Hypervisor
NVMe SSD → AI Dataset / Scratch / Model Storage
در نظر گرفت.
البته انتخاب RAID باید براساس نیاز به Performance، Availability و ظرفیت نهایی انجام شود.
13. معماری پیشنهادی Workload
این سرور را میتوان برای چند دسته اصلی Workload استفاده کرد:
Generative AI
- LLM Inference
- RAG
- Embedding Generation
- Text Generation
- Multimodal AI
AI Development
- Fine-Tuning
- LoRA / QLoRA
- Model Evaluation
- Training کوچک تا متوسط
- Hyperparameter Experiments
HPC
- Scientific Computing
- Simulation
- Numerical Analysis
- CUDA Applications
Data Processing
- Big Data
- Vector Search
- Data Analytics
- AI Pipeline
14. معماری اجرای LLM
یکی از سناریوهای جذاب این سیستم، اجرای مدلهای بزرگ زبانی است.
در این معماری:
                 USER / APPLICATION
                        │
                        ▼
                AI / Inference Layer
                        │
                ┌───────┴───────┐
                │               │
             H200 NVL       H200 NVL
             141GB HBM3e    141GB HBM3e
                │               │
                └────── NVLink ─┘
                        │
                  PCIe / CPU Fabric
                        │
          ┌─────────────┴─────────────┐
          │                           │
     Xeon 6960P                   Xeon 6960P
       72 Core                      72 Core
          │                           │
          └──────────┬────────────────┘
                     │
                  1TB DDR5
                     │
              ┌──────┴──────┐
              │             │
          NVMe Gen4      SATA SSD
          15.36TB         1.92TB
این معماری یک Node محاسباتی متراکم ایجاد میکند که در آن GPUها مسئول AI Compute، CPUها مسئول orchestration و processing و NVMe مسئول High-Speed Data I/O هستند.
15. نکته مهم درباره Training
نباید از وجود دو H200 نتیجه گرفت که این سیستم الزاماً یک Training Cluster کامل است.
Training مدلهای بسیار بزرگ، خصوصاً مدلهای صدها میلیارد پارامتری، معمولاً نیازمند:
- تعداد GPU بیشتر
- GPU Interconnect گستردهتر
- Network Fabric پرسرعت
- RDMA
- Storage مشترک
- Distributed Training
است.
بنابراین این سیستم از نظر معماری میتواند یک AI Compute Node قدرتمند باشد؛ اما در مقیاس Enterprise، چندین Node میتوانند با یکدیگر یک Cluster تشکیل دهند.
16. نکته بسیار مهم درباره Supermicro SYS-522GA-NRT و H200 NVL
اینجا یک نکته فنی را عمداً باید در مقاله ذکر کنیم.
خود Supermicro مشخصات SYS-522GA-NRT را برای GPUهای PCIe و معماری Dual-Root ارائه میکند؛ با این حال، در FAQ رسمی که در 28 August 2026 منتشر شده، Supermicro تصریح کرده که H200 NVL در فهرست GPUهای Validateشده این مدل قرار ندارد. Supermicro
بنابراین برای یک پیشنهاد تجاری یا پروژه Enterprise، نباید صرفاً بر اساس امکان فیزیکی نصب GPU نتیجه گرفت که Configuration مورد نظر Certified است.
قبل از تحویل نهایی باید موارد زیر تأیید شوند:
- GPU Compatibility
- BIOS Revision
- PCIe Topology
- Power Budget
- Thermal Envelope
- GPU Firmware
- Driver/CUDA Compatibility
- NVLink Bridge Compatibility
- GPU Placement
- NVIDIA Certification Status
این موضوع برای یک مقاله تخصصی اتفاقاً نقطه قوت محسوب میشود؛ چون تفاوت بین Physical Compatibility و Validated Configuration را نشان میدهد.
17. توان مصرفی و طراحی حرارتی
این موضوع در چنین سروری بسیار مهم است.
Xeon 6960P دارای TDP حدود 500W برای هر CPU است. Intel
دو CPU:
≈ 1000W
و دو H200 NVL نیز هر کدام تا حدود 600W TDP دارند. NVIDIA
بنابراین فقط CPU + GPU در بدترین حالت:
حدود 2.2kW
توان حرارتی ایجاد میکنند؛ بدون احتساب:
- Memory
- SSD
- Motherboard
- Fans
- NIC
- PSU losses
- Other PCIe devices
بنابراین طراحی Rack، PDU، UPS و Cooling باید با در نظر گرفتن Peak Load انجام شود.
Supermicro برای این پلتفرم نیز از طراحی توان و خنککنندگی متناسب با GPUهای پرمصرف استفاده کرده است. Supermicro
18. نتیجهگیری فنی
ترکیب:
2 × Intel Xeon 6960P
1TB DDR5-6400
2 × NVIDIA H200 NVL 141GB
NVLink
15.36TB NVMe Gen4
1.92TB SATA SSD
یک معماری کاملاً GPU-Oriented برای محاسبات شتابیافته ایجاد میکند.
نقطه اصلی این طراحی صرفاً تعداد هسته CPU نیست؛ بلکه ترکیب چند لایه است:
High-Core CPU + Large System Memory + High-Bandwidth HBM3e + NVLink + PCIe Gen4/Gen5 Storage
این ترکیب میتواند برای AI Inference، RAG، Fine-Tuning، مدلهای Generative AI، پردازش داده و برخی Workloadهای HPC مورد استفاده قرار گیرد.
از سوی دیگر، برای استفاده در محیط Production باید سازگاری نهایی H200 NVL با SYS-522GA-NRT، Firmware، BIOS، Power Budget و Thermal Configuration بهصورت رسمی تأیید شود. این موضوع بهخصوص به دلیل وضعیت Validation اعلامشده توسط Supermicro اهمیت دارد. Supermicro
مشخصات کلیدی در یک نگاه
| پارامتر |
مقدار |
| Server |
Supermicro SYS-522GA-NRT |
| Form Factor |
5U |
| CPU |
2 × Intel Xeon 6960P |
| CPU Cores |
144 Cores Total |
| CPU Cache |
864MB Total |
| RAM |
1TB DDR5-6400 |
| GPU |
2 × NVIDIA H200 NVL |
| GPU Memory |
282GB HBM3e مجموعاً |
| GPU Memory Bandwidth |
4.8TB/s per GPU |
| GPU Interconnect |
NVLink 2-Way |
| NVMe |
15.36TB |
| SATA SSD |
1.92TB |
| Raw Storage |
17.28TB |
| Primary Use |
AI / HPC / Inference / Fine-Tuning |


دیدگاهها
پاککردن فیلترهاهیچ دیدگاهی برای این محصول نوشته نشده است.